Zgodny z Redis pamięciowy magazyn z natywnym wyszukiwaniem wektorowym
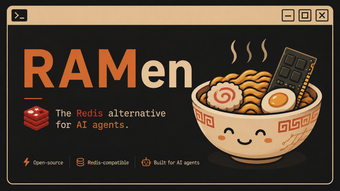
RAMen, autorstwa Rohit Dnath, to pamięciowy magazyn danych stworzony, aby wspierać procesy robocze napędzane przez AI oraz pamięć agentów. Narzędzie akceptuje dostęp w stylu klucz-wartość, dodając jednocześnie semantyczne wyszukiwanie, dzięki czemu aplikacje mogą pobierać treści na podstawie znaczenia zamiast dokładnych dopasowań. Jest skierowane do deweloperów AI i inżynierów backendowych, którzy potrzebują lokalnego magazynu, aby zredukować opóźnienia i unikać powtarzających się wywołań modelu, oraz integruje się z ekosystemami agentów, które używają protokołu do wymiany kontekstu modelu.
Jakie zadania można faktycznie wykonać za jego pomocą?
Narzędzie działa jako pamięć operacyjna, która łączy dostęp w stylu Redis z wyszukiwaniem wektorowym i semantycznym dla obciążeń AI. Akceptuje polecenia protokołu Redis, udostępnia pamięć podręczną semantyczną do wyszukiwań opartych na znaczeniu i uruchamia serwer Model Context Protocol, do którego agenci mogą bezpośrednio wysyłać zapytania. Główna implementacja jest napisana w Go i zoptymalizowana pod kątem wydajności w pamięci operacyjnej, więc przypadki użycia obejmują szybkie lokalne wyszukiwanie dla pamięci agenta, kontekstu sesji i odpowiedzi LLM w pamięci podręcznej.
Jak dokładne jest wyszukiwanie semantyczne dla przepływów pracy AI?
Pamięć podręczna semantyczna przechowuje i pobiera odpowiedzi AI na podstawie znaczenia, a nie dokładnych dopasowań słów kluczowych, co ma na celu zmniejszenie liczby wywołań LLM i obniżenie opóźnienia podczas pobierania. Wbudowane wyszukiwanie wektorowe obsługuje osadzenia o wysokiej wymiarowości, aby wspierać te wyszukiwania. Wyniki odzwierciedlają jakość indeksu i osadzenia, dlatego zespoły powinny weryfikować odpowiedzi z pamięci podręcznej w odniesieniu do danych aplikacji, zanim polegają na nich w decyzjach faktograficznych lub o wysokiej stawce.
Jakie środowiska i klienci są obsługiwani?
Model dystrybucji to pojedynczy plik binarny Go, co upraszcza wdrożenie w systemach, które mogą uruchamiać programy Go. Narzędzie implementuje protokół Redis, dzięki czemu istniejący klienci Redis i bazy kodu mogą współdziałać bez znaczących modyfikacji. W przypadku przepływów pracy agentów integruje się z dowolnym klientem AI lub platformą, która obsługuje Model Context Protocol, z nazwanymi przykładami, w tym Claude Desktop i Cursor, umożliwiając bezpośredni dostęp do danych przez agentów.
Czy łatwo jest wdrożyć w istniejących stosach?
Wdrożenie koncentruje się na ergonomii programisty i gotowości do open-source. Licencja BSD-3-Clause i projekt hostowany na GitHubie sprawiają, że ponowne użycie kodu jest proste, a doświadczenie programisty w systemach backendowych, Node.js, TypeScript i Go sugeruje nacisk na dyscyplinę API i wdrożenia. Ponieważ narzędzie jest skierowane do inżynierów i twórców agentów AI, można się spodziewać przepływu pracy zorientowanego na rozwój, który sprzyja integracji repozytoriów, konfiguracji na poziomie kodu i iteracyjnemu testowaniu, a nie graficznej administracji.
Kto powinien rozważyć to narzędzie
Narzędzie jest pragmatycznym wyborem dla zespołów inżynieryjnych budujących usługi wspierane przez agentów, które potrzebują lokalnego pobierania i kontroli dewelopera. Jego orientacja na open-source wspiera integrację opartą na repozytoriach, ale zespoły powinny weryfikować wyniki pamięci semantycznej w odniesieniu do swoich zbiorów danych i potwierdzić, że ich agenci mogą uzyskać dostęp do magazynu za pomocą wymaganego protokołu kontekstowego przed wdrożeniem na dużą skalę. Traktuj to jako komponent inżynieryjny, a nie produkt końcowy do natychmiastowego użycia.